Rebuilding a Data Operation Pipeline
기존 운영 절차를 분해하고 레거시 모듈의 동작을 분석해 기능을 이관하는 동시에, 실행 환경의 자원 제약과 운영자의 사용성을 고려한 작업 흐름 전반의 재설계
Problem
유지관리 프로젝트로 발령받아 업무 절차를 인수인계받던 도중, 도저히 납득하기 어려운 작업 절차를 맞닥뜨리게 됐다. 시스템의 연계 데이터 적재, 동기화 및 공개 관리 절차가 이미지 없이는 설명이 불가능할 정도로 복잡해서, 이미지를 포함한 문서가 9장이 넘어가는 분량이었다. 엎친 데 덮친 격으로 기존 적재 모듈이 개발됐을 당시와는 실행 환경까지 달라져, 메모리가 수시로 터지는 상황까지 발생하고 있었다.
이 복잡한 절차를 전부 기억할 자신도 없었고, 그렇다고 매번 문서를 보며 따라 하기에는 다른 업무를 병행하기 어려운 수준이었다. 생존을 위해서는 이건 바꿔야겠다고, 처음 인수인계를 받던 날부터 생각했다. 그렇게 레거시 모듈과 업무 절차를 분석해 재설계를 진행하게 됐다. 본격적으로 구현에 돌입하기 전에 먼저 식별한 문제들은 다음과 같았다.
- 기존 Java 모듈의 실행 환경은 물리 PC를 기준으로 설정되어, VDI의 4코어 CPU와 8GB 메모리라는 제한된 실행 환경이 고려되지 않음. OS 및 기본 프로세스만으로도 약 4GB의 메모리를 점유하는 환경.
- 기존 모듈은 특정 IDE를 통해서만 실행할 수 있었으며, 전자정부프레임워크 개발환경을 요구함. 작업을 수행하지 않고 IDE만 실행한 상태에서도 약 1.5GB의 메모리 점유.
- 특히 동기화 작업에서 실제 작업 수행 중 JVM Heap 부족으로 인한
OutOfMemoryError가 빈번하게 발생. - IDE의 콘솔 출력 외 작업 진행과 오류 로그를 확인할 수단이 없으며, 데이터베이스에서 직접 완료 작업 건수를 조회하거나 인코딩 문자열을 검수하는 등의 별도 검증 절차 필요.
- 특정 대용량 적재 명령인
edbldr를 실행하기 위해 별도의 3개 파일을 추가로 생성하고 관리해야 하는 업무 절차 복잡성. 파일 실행 권한이나 OS 인코딩 차이 등 휴먼 에러 발생 가능 지점 다수. - 적재된 데이터를 플랫폼에서 공개하는 과정도 별도의 운영 서버 스크립트 두 개를 차례로 실행해야 하는 구조. Excel의 수식 결과를 조절하고 Windows에서 Linux 운영 서버로 직접 복사하는 등의 높은 수작업 의존성.
실행 환경의 컴퓨팅 자원 제약으로 인한 안정성 저하, 지나치게 복잡한 적재 및 공개 절차, 그리고 불투명한 작업 진행 상황과 결과 확인 방법 등 여러 방면을 개선하고자 했다.
Environment
기본 환경은 운영 시스템의 기술 스택에 익숙해질 겸 Python을 사용했다. 운영 시스템에 삽입될 코드가 아니고, 독립 실행 파일로 배포할 생각이어서 버전은 운영 시스템과 맞추지는 않았다.
Cesium 유틸리티 NPM 패키지 환경 구성에서의 경험을 살려, 먼저 Python의 패키지 의존성 관리를 위해 uv 패키지 매니저를 사용했다. Node.js 생태계에서의 패키지 관리 도구와 사용 방식이 유사하고, Python 이외의 별도 런타임이나 시스템 의존성을 관리할 필요는 없었기 때문이다.
Considerations
이러한 문제를 해결하기 위해 기존 모듈의 동작과 운영 절차를 분석하고, 기능 이관과 함께 실행 환경의 제약 및 운영 편의성을 고려한 재설계를 진행했다.
이하에서는 고려사항을 주제별로 분류하기보다, 설계 과정에서 실제로 거쳤던 판단의 순서와 그 근거를 중심으로 정리한다.
User Interface
다른 것들보다 우선 결정한 것은 실행 인터페이스이다. 특정 IDE의 설정에 종속되어 있는 실행 환경, 하드코딩된 데이터베이스 접속 정보, 데이터의 종류에 따라 다른 실행 절차, 기능마다 다른 데이터 입력 경로 등, 일관되지 않은 실행 인터페이스가 사용에 어려움을 겪게 한 큰 이유 중 하나였다.
이에 따라 작업 확장성과 실행 옵션의 유연성 등을 고려해 Command Line Interface(CLI)로 실행 인터페이스를 통합하기로 했다. 데이터베이스 접속 정보처럼 반복적으로 사용하는 설정은 JSON에 담아 사용하되, 필요에 따라 읽어올 설정 파일 경로를 옵션으로 지정할 수 있도록 구성했다. 이는 Node.js의 개발 보조 패키지들에서 사용하던 설정 지정 형식을 빌려왔다.
별도 경로를 지정하지 않으면 실행 파일과 같은 디렉터리의 기본 설정 파일을 사용하며, -c 옵션을 통해 다른 설정 파일의 경로를 지정할 수도 있다.
Procedure
운영 절차의 복잡성도 지나치게 높았다. 인수인계 문서에서의 데이터 적재 과정만 살펴보더라도, 여러 도구를 오가며 테이블의 생성부터 작업 결과 검증까지 여러 단계를 직접 수행해야 했다.
- DB 관리 도구: 과거 테이블 DDL 복사, 날짜 수정, 테이블 생성
- SSH: DB 서버에서 작업년월 디렉토리 생성, mkdir.sh 실행
- IDE: 모듈 실행 → 테이블마다 insert.sh, .data, .ctl 생성
- FTP: 데이터별 3개 파일을 mkdir.sh로 만든 디렉터리에 복사
- SSH: 같은 경로로 이동해 insert.sh 실행
- DB 관리 도구: 완료 건수, 테이블 크기 직접 조회
- IDE: 별도 모듈 기능으로 결과 테이블에 디코딩 오류 검사 실행
재설계한 모듈은 실행 파일이 있는 경로에서 명령 프롬프트를 열고, 테이블명과 날짜, 데이터 경로만 지정하면 적재 작업을 수행할 수 있도록 했다.
기존 테이블의 메타데이터를 조회해 날짜에 맞는 테이블을 생성하고, 데이터 처리 파이프라인에서 디코딩 오류를 검사하며, 별도의 파일을 생성하지 않고 PostgreSQL의 COPY를 사용해 데이터를 적재하도록 했다. 기존에 여러 도구를 오가며 수동으로 수행하던 작업을 하나의 실행 인터페이스와 데이터 파이프라인으로 통합한 것이다.
Constraints
이번 재설계에서는 모듈이 실행될 환경이 Virtual Desktop Infrastructure(VDI)라는 제약이 중요하게 작용했다. 플랫폼은 내부망에 고립된 환경에서 운영되며, 이를 관리하는 작업도 VDI 안에서 이루어진다. 할당된 VDI는 4코어 CPU, 8GB 메모리, 80GB 스토리지로, OS를 제외하면 여유 공간이 50GB도 되지 않는 꽤나 열악한 환경이다.
외부 개발 환경과 내부망 사이의 파일 반입은 망연계 솔루션을 거쳐 반입했기 때문에 VDI 내에 개발 환경을 구성하고 유지하는 데에는 상당한 번거로움이 있었고, 제한된 자원에 환경을 추가 구성하는 것도 부담스러웠다.
Deployment
그래서 외부망 접속이 가능한 PC에서 개발을 진행하고, PyInstaller를 사용해 Python 런타임과 의존성을 포함한 단일 실행 파일(.exe)로 패키징한 후 내부망으로 반입하는 방법을 선택했다.
반입할 파일의 크기도 기존 Java 레거시 실행 환경이 1.59GB였던 것에 비해, Python 런타임과 의존성을 모두 포함한 .exe는 17.2MB였다.
저장 용량뿐만 아니라 실행 환경의 추가 메모리 점유율 측면에서도 큰 개선을 이루었다. 기존 모듈이 IDE 및 전자정부프레임워크만으로 약 1.5GB를 점유했던 것과 달리, 재설계한 모듈은 명령 프롬프트만으로 직접 실행할 수 있어, 상시 메모리 점유를 제거할 수 있었다.
다만 PyInstaller는 크로스 컴파일을 지원하지는 않아서 실행 대상 운영체제에 맞는 환경에서 빌드해야 한다. 이번 경우에는 PC(Windows 11)에서 빌드한 결과가 VDI(Windows 10)에서 정상 작동하여 호환성을 따로 고려하지는 않았다.
별도의 CI/CD 파이프라인을 구성하지는 않았지만, 빌드 과정에서 기본적인 코드 품질 검증이 이루어지도록 Taskipy로 검사 및 빌드 명령을 묶어두었다. 자동 포맷팅과 코드 컨벤션 및 타입 검사, 유닛 테스트를 모두 거친 후에만 빌드하도록 명령을 구성했다.
Resource
설계에서는 가용 컴퓨팅 자원 제약의 영향이 컸다. 운영 및 유지관리 업무의 특성상 데이터 작업에 모든 자원이 집중되어 다른 업무가 마비되는 상황은 바람직하지 않았기 때문에, 설계 전반에 걸쳐 자원 점유율을 억제하면서도 적절히 속도를 챙겨야 한다는 점을 최우선 목표로 삼았다.
메모리 사용량 억제를 위한 방법으로 Generator 기반의 데이터 스트림 처리를 선택했다. CSV 형식의 텍스트 파일을 ZIP 압축 파일로 제공하는 데이터 연계 인터페이스에 따라, 압축 푼 텍스트 파일을 한 번에 읽어 처리하던 기존의 레거시 Java 방식 대신 행 단위로 제공하고 소비하는 을 설계했다.
처리량을 높이기 위해 멀티 프로세싱과 커넥션 풀을 검토하기도 했다. 하지만 컬럼 수가 많은 데이터는 프로세스 하나만으로도 코어 하나를 한계치까지 사용했고, 프로세스를 늘리기에는 앞서 정한 자원 점유 억제 기준과 충돌했다. 커넥션 풀도 검토했지만, 단일 프로세스에서의 순차적인 스트림 처리 구조에서는 동시에 사용할 커넥션이 필요하지 않았다. 오히려 커넥션 생명주기와 트랜잭션 관리 복잡도만 증가할 수 있다고 판단해 단일 커넥션을 사용하는 방향을 선택했다.
스토리지에 추가 여유 공간이 확보되어야 하는 문제도 있었다. 입력 경로에 데이터 압축을 푼 텍스트 파일들과, 그 파일들을 .data로 합친 결과를 저장할 공간이 필요했기 때문이다. 처리할 데이터에 따라 최대 약 50GB까지도 요구했다. 이 부분은 스트림을 ZIP 파일 엔트리에서 직접 제공하도록 변경하고, 프로세스 내에서 별도 파일 없이 바로 데이터베이스에 넘겨주는 방법으로 해결했다.
Modular Architecture
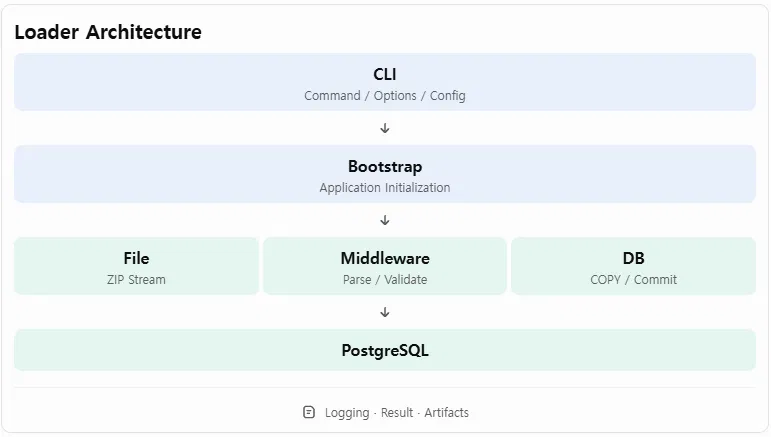
본격적인 구현으로 들어가기 전, 데이터 흐름에 따라 계층 구조를 먼저 나눴다.
| Layer | Description |
|---|---|
file | ZIP 파일을 읽어 내부 파일의 텍스트 스트림을 제공하는 데이터 파이프라인의 시작점 |
middleware | CSV 형식 텍스트 라인을 컬럼별 값으로 구성된 row 객체로 변환, 디코딩 오류 등을 처리하는 중간 단계 |
db | 처리된 row 스트림을 데이터베이스에 적재하는 데이터 파이프라인 종료 지점 |
이 세 계층을 중심으로 구현을 진행하면서 사용자 진입점인 cli, 애플리케이션 설정 조율용 config 등이 추가로 식별되었다. 이에 따라 계층 구조도 구현 과정에서 지속적으로 수정됐다.
TypeScript를 사용하던 습관도 일부 반영됐다. 데이터 구조를 dataclass와 타입 annotation으로 명시적으로 정의하고, 이런 타입 정의들을 schema로 묶은 구조가 그것이다.
최종적으로는 위의 그림과 같이 이어지는 흐름을 구성했다. cli를 통해 진입 및 명령 입력, bootstrap에서 애플리케이션 필수 설정 초기화, file → middleware → db를 거친 데이터 스트림 처리, 작업 결과를 schema에 정의한 타입으로 반환하며, 각 계층의 책임을 분리하여 CLI 없이도 호출할 수 있도록 구성했다.
Streaming Pipeline
이번 재설계의 핵심으로, VDI 환경에서의 자원 제약이 가장 크게 작용한 부분이다.
적재 대상 테이블에 대한 연계 데이터 압축 파일은 여러 개로 나뉘어 들어왔다. 문제는 압축을 푼 파일들의 용량이 약 23GB, 합쳐진 결과는 25GB가 넘어가는 대용량 데이터도 있었다는 점이다.
따라서 앞서 구분한 데이터 흐름 계층을 중심으로, Python Generator의 지연 평가(Lazy Evaluation) 특성을 적극 활용해 스트림 파이프라인을 설계했다.
파이프라인의 시작점은 ZIP 파일 처리 시점으로 설정했다. CLI 입력으로 받은 경로의 대상이 파일이면 해당 파일만, 디렉토리면 디렉토리 내 모든 ZIP 파일을 순회한다. 내장 모듈로 ZIP 파일을 처리할 수 있다는 점이 Python을 고른 이유 중 하나이기도 했다. 데이터 연계 인터페이스에서는 "ZIP 파일 하나당 CSV 형식 .txt 파일 하나"를 기본 규칙으로 하지만, 복수 파일이 존재할 때도 처리할 수 있게 내부 엔트리를 순회하도록 설계했다.
이렇게 생성된 스트림은 소비 측에서도 몇 가지 규칙을 지켜야 했다.
- 순차 소비: 엔트리는 순서대로 처리하며, 현재 엔트리가 끝난 뒤 다음으로 이동
- 완결 소비: 각 엔트리의 스트림을 끝까지 소비한 후 종료
- 지연 소비: 리스트로 변환하지 않고, 실제 처리 시점에
Iterator순회
스트림을 순차적으로 끝까지 소비하지 않으면 파일 핸들이 열린 채 남을 수 있고, 스트림을 리스트로 변환하면 그 순간 메모리에 올라가기 때문이다.
이후 문자열 스트림의 리스트 객체 변환, 디코딩 오류 검사, DB 적재 등은 모두 이 스트림 파이프라인의 소비 규칙을 따라 작성했고, 이 규칙을 검증하기 위한 단위 테스트도 추가로 구성했다.
다만 마지막 DB 적재의 경우, 행 단위로 요청을 보내자 간헐적으로 1초 정도의 지연이 꽤 자주 발생해서, 처음에는 100만 건을 기준으로 처리 완료된 스트림을 모아서 PostgreSQL의 COPY로 전달하게끔 chunk(청크)를 구성했었다.
그런데 구현 중, 마지막 단계에서 실패하면 트랜잭션이 롤백되어 작업 내용이 모두 초기화된다는 점을 발견했다. 트랜잭션 단위로는 정상적인 롤백 동작이었지만, 수억 건을 몇 시간에 걸쳐 진행해야 하는 대용량 작업의 특성상 이는 실패 비용이 너무 컸다.
따라서 청크 단위로 커밋하고, 실패한 청크만 롤백 및 격리하고 나머지는 계속 진행하는 정책을 택했다. 이게 가능했던 이유는, DB에 적재가 되더라도, 플랫폼에서 데이터를 사용자에게 해서, 작업 중인 데이터가 노출될 일이 없었기 때문이다.
청크의 크기는 DB 요청 횟수, 메모리 사용량, 실패 격리 범위를 고려해 결정했다. 크게 잡으면 DB 요청 횟수는 줄지만 메모리 사용량과 실패 격리 범위가 늘고, 작게 잡으면 반대로 요청이 잦아진다. 처음 잡았던 100만 건은 실패 범위와 메모리 사용량 면에서 너무 컸고, 1천 건 이하는 요청이 너무 잦아질 것으로 예상되어, 최종적으로 1만 건으로 조정했다. 실패 청크는 로그를 남기며 다시 시도할 수 있는 형태의 별도 파일로 저장된다.
결과적으로는 전체 데이터를 메모리에 올리지 않고 일정 크기의 청크만 유지하면서 처리할 수 있게 되어 메모리 사용량을 안정적으로 관리할 수 있었다. 이에 더해 압축을 풀지 않고 내부 파일을 직접 읽을 수 있어 VDI 스토리지에 압축을 풀어 둘 필요도 없게 됐다. 이 설계는 다룰 데이터가 줄바꿈으로 행이 구분되는 CSV 형식 텍스트라는 점 때문에 가능했다.
Observability
기존 모듈은 IDE의 콘솔에 종속되어 작업 로그를 따로 확인할 수 있는 방법이 없었다. 로그 출력이 멈추면 IDE 콘솔 출력이 멈춘 건지, 작업이 중단된 건지도 알 수 없었고, 로그 기록도 일관성이 없어서 무슨 작업을 진행한 로그인지도 확인하기 어려웠다.
CLI로 인터페이스를 확정한 뒤, 표준 logging에 rich의 핸들러를 연결해 콘솔 출력을 정리하고, 같은 로그를 실행 파일 경로 기준의 artifacts_dir에도 남겼다. 이곳에는 로그뿐 아니라 실패한 청크와 디코딩 오류 원본 텍스트 등을 함께 남겨, 작업이 끝난 뒤에도 무슨 일이 있었는지 확인할 수 있었다.
장시간 작업이 살아 있는지 알 수 없던 문제는 rich의 진행률 표시인 Progress로 풀었다. 이는 파이프라인을 건드리지 않도록 스트림을 감싸는 방식으로 구현했다. 그래서 전체 대비 진행률이나 남은 시간은 표시할 수 없지만, 필요한 건 작업이 살아 있는지 확인하는 것뿐이어서 거기서 멈췄다.
그런데 함수 단위의 로그만으로는 작업의 결과를 한눈에 파악하기가 어려웠다. 한 기능의 상태보다는 연관된 작업을 전체적으로 조망할 수 있는 형태가 필요했고, 이에 따라 아키텍처를 다시 손봤다.
기능별 함수들을 클래스로 묶고, 각 클래스가 작업 단위별 유의미한 결과 건수를 집계하는 Result 타입을 갖도록 했다. 덕분에 작업이 끝나면 파일별 처리 건수와 전체 합계가 하나의 요약으로 남는다. 클래스로 묶으면서 하위 함수들이 공통으로 쓰던 파라미터는 작업별 Context로 모을 수 있었고, 작업마다 logger 이름을 지정해 로그가 어디서 발생했는지도 구분했다.
그 결과 작업이 끝나면 다음과 같은 요약이 남는다.
기존에 DB 매니저로 직접 조회하던 완료 건수와 테이블 크기도 이 요약에 포함된다.
Synchronize
실제로 메모리 문제가 발생했던 부분은 대량 데이터 적재가 아닌, 적재된 변경분을 현행 테이블에 반영하는 동기화 작업이었다.
동기화에 필요한 데이터는 일별 변경 데이터와 변경 명령 데이터로 구분되어 전달된다. 변경 명령에는 대상 테이블과 기본 키(PKEY), 변경 유형 등의 정보가 포함되어 있으며, 이를 기준으로 각 테이블에 전달된 변경 데이터를 매칭하고 현행 데이터에 반영해야 한다.
기존 모듈은 이 작업을 LinkedList 자료 구조를 활용해 처리하고 있었다. 변경 명령과 데이터를 매칭하고 INSERT, UPDATE, DELETE 여부를 판별하는 과정까지 모두 애플리케이션에서 수행하는 방식이었다. 변경 명령 N건과 각 명령에 대응하는 K개 컬럼의 데이터를 메모리에 보관하여 **O(N × K)**의 공간을 차지하는 구조였다.
이 구조에서는 변경 명령의 수가 증가할수록 메모리 사용량도 함께 증가한다. 특히 변경 명령이 대량으로 발생하는 경우, 실제 데이터 변경 작업에 앞서 명령 자체를 메모리에 보관하는 것만으로도 상당한 메모리를 소비하게 된다. 일일 변경 건수 약 1600만인 상황이 발생했을 때, 작업 자체를 시도조차 할 수 없었다.
이를 개선하기 위해 동기화 처리 구조를 재설계했다.
재설계 모듈의 서브 커맨드로 실행 가능하도록 통합하면서, 기존에 구현한 스트리밍 및 COPY 기반 적재 기능을 활용해 변경 명령과 테이블별 변경 데이터를 각각 임시 테이블(Staging Table)에 적재하도록 했다. 이후 애플리케이션이 직접 수행하던 변경 명령과 데이터의 매칭, 최신 변경 명령의 판별, INSERT 및 UPDATE 대상 결정 등의 작업을 DB 엔진에서 처리하도록 변경했다. 변경 명령 테이블에서 기본 키별 최신 명령을 추출하고, 이를 변경 데이터 임시 테이블과 JOIN하여 실제 반영할 데이터를 결정한다.
결과적으로 기존의 애플리케이션 중심 처리 방식에서 DB 중심의 집합 연산 방식으로 전환했고, 대량의 변경 명령이 발생하는 상황에서도 보다 안정적으로 동기화 작업을 수행할 수 있는 구조를 마련했다.
실패 처리 정책 역시 적재 작업과는 다르게 설계했다. 날짜별 변경분을 하나의 작업 단위로 정의하고, 해당 날짜의 모든 테이블에 대한 변경 작업을 하나의 트랜잭션으로 처리하도록 구성했다. 특정 테이블에서 작업이 실패하면 해당 날짜에 수행한 모든 변경을 롤백하고 이후 날짜의 동기화도 중단한다.
이는 변경분이 날짜 순서에 따라 누적 적용되는 데이터라는 특성을 고려한 것이다. 이전 날짜의 변경이 정상적으로 반영되지 않은 상태에서 이후 날짜의 변경을 적용하면 데이터의 일관성을 보장하기 어렵기 때문이다. 따라서 날짜 단위의 원자성을 보장하고, 실패한 시점 이후의 변경분이 적용되지 않도록 했다.
다만 운영 환경에서 TEMP TABLE 사용 시 DB 엔진이 비정상 종료되는 경우가 보고된 적이 있었다. 정확한 발생 조건이나 원인은 확인할 수 없었고, 운영 DB에서 이를 재현하는 것도 위험하다고 판단했다. 어쩔 수 없이 일반 테이블을 사용하여 임시 테이블로 활용하게 되었는데, 정리 로직을 고려하지 않을 수 없어서 이 부분이 조금 복잡해졌다.
커넥션 관리에서도 예상하지 못한 문제가 있었다. Staging Table의 생성 및 삭제 과정에서 커넥션을 유지한 상태로 작업을 수행할 경우 후속 작업이 정상적으로 이루어지지 않는 현상이 발생했다.
정확한 원인은 확인하지 못했지만, 작업 단계별 커넥션을 분리하는 방식으로 우회했다. 프로세스 강제 중단(Ctrl + C), 테이블 복사 실패 상황에서는 정상적으로 테이블이 삭제되는 걸 확인했지만, 이 구현이 모든 예외 상황을 처리할 수 있는지 검증하지는 못했다.
Publishing
이 서비스 플랫폼의 특징적인 부분 중 하나로, 데이터베이스에 등록된 리소스에 대한 URL을 플랫폼에 등록해줘야 사용자들이 실질적으로 접근이 가능해지는 공개 절차가 따로 존재한다. 그런데 적재 작업과 마찬가지로, 이 공개 절차도 너무 복잡했다. IDE는커녕, 프로그램과 운영 체제를 오가며 작업해야 했고, 운영 서버 환경에 종속된 스크립트를 사용했다.
- Windows 환경에서 엑셀 파일의 수식에 적용할 값을 수정
- 수식 결과를 별도 텍스트 에디터에 복사한 후 인코딩 변환
- 인코딩을 변경한 텍스트를 운영 Linux 서버 내의
input_resource.txt에 복사 - 운영 서버에서 플랫폼에 등록된 데이터 형식을 읽어와 입력값을 이에 맞게 수정하는 스크립트 실행
- 스크립트 실행 결과인
output_resource.txt검수 - 운영 서버에서 플랫폼에 해당 형식을 업로드하여 데이터에 접근 가능한 URL을 생성하는 스크립트 실행
기존 스크립트가 수행하던 4번과 6번 과정은 플랫폼 API를 호출하는 작업이었다. 해당 API가 VDI에서도 접근 가능하다는 점을 확인해, 별도의 운영 서버 스크립트 없이 CLI 기반의 독립 실행 파일로 이관할 수 있었다. 다만 여기서 input_resource.txt와 output_resource.txt의 생성 과정은 간소화하되, 생성 결과물과 결과 검수 과정은 그대로 보존했다. 작업 흐름을 분리해 마지막 단계에서 데이터가 최종 공개되기 전에 사람이 개입해야 할 부분을 의도적으로 남겨야겠다고 판단했기 때문이다.
이는 작업 목적이 다르다고 판단하여, 재설계한 모듈에 함께 담지 않고 별도 모듈로 구성했다. 설정 값을 JSON에 담거나 CLI를 통하는 실행 인터페이스 구성은 적재 모듈을 재사용했지만, 내부 구조는 훨씬 단순하게 설계했다. 적재 모듈은 데이터 흐름에 따라 여러 계층으로 나눌 필요가 있었던 반면, 공개 모듈은 입력값을 플랫폼에서 요구하는 형식으로 변환하고 API에 전달하는 과정이 전부였기 때문이다.
Result
전반적인 모듈 재설계 결과는 다음과 같다.
| 구분 | 이전(레거시) | 이후(재설계) |
|---|---|---|
| 실행 인터페이스 | IDE 종속 | CLI |
| 실행 환경 | Java + 전자정부프레임워크 IDE | Python 독립 실행 파일 |
| 배포 크기 | 약 1.59GB | 17.2MB |
| 메모리 사용량 | IDE만으로 약 1.5GB, 작업 중 JVM Heap 부족 발생 | 평균 약 60MB, 최대 약 70MB |
| 데이터 임시 저장 공간 | 압축 해제 및 적재 파일 생성 공간 필요 | 필요 없음 |
| 작업 결과 | DB 직접 조회 및 별도 검증 | 로그 및 결과 자동 집계 |
| DB 적재 방식 | edbldr 명령 | PostgreSQL COPY |
재설계한 모듈로 실제 운영 데이터 기준 약 3,991만 건부터 2억 4,121만 건까지의 데이터를 처리한 적재 작업 결과:
| 데이터 건수 | 소요 시간 | 평균 처리량 |
|---|---|---|
| 39,912,019 | 42분 24초 | 15,687 row/s |
| 63,086,827 | 45분 58초 | 22,872 row/s |
| 241,212,347 | 4시간 9분 21초 | 16,123 row/s |
기존 모듈은 여러 작업이 개별적으로 진행되어 전체 소요 시간을 정확하게 측정하기는 어려웠다. 2억 4,121만 건에 대해서는 확인 가능한 개별 작업의 추정 소요 시간만 합산해도 약 4시간이 소요되었고, 측정하기 힘든 공수가 추가로 들었다. 작업을 진행하는 VDI는 작업이 끝날 때까지 마비 상태에 가까웠다.
반면 재설계 모듈은 ZIP 파일 처리부터 파싱, 인코딩 검사 및 DB 적재, 검증까지 전체 파이프라인을 하나로 통합했고, 이를 기준으로 측정한 전체 파이프라인에 대한 평균 처리량은 초당 15,687~22,872건이었다.
동기화 작업 역시 처리 구조를 재설계하면서 애플리케이션의 메모리 의존성을 줄였다. 기존에는 변경 명령과 데이터를 애플리케이션 메모리에 적재하고 직접 매칭하는 구조였지만, 재설계 이후에는 Staging Table을 활용해 DB 엔진에서 변경분을 처리하도록 변경했다. 이를 통해 대량의 변경 명령을 애플리케이션 메모리에 유지할 필요가 없어졌으며, 트랜잭션의 경계를 날짜 단위로 설정하여 실패 시 데이터 일관성을 유지하도록 했다.
적재와 동기화 작업 모두 Windows 작업 관리자에서 확인한 프로세스 메모리 사용량은 평균 약 60MB, 최대 약 70MB 수준이었다. 별도의 추가 스토리지 할당 없이 대용량 데이터를 처리하면서도 제한된 VDI 환경에서 낮은 메모리 점유율을 유지할 수 있었다.
공개 작업은 실행 절차 측면에서 가장 큰 개선을 이루었다. Excel의 수식에 값을 입력하고, 편집 도구를 통해 그 결과값의 인코딩을 직접 수정한 후, 서버에서 지정된 경로로 복사하는 등의 여러 수작업을 거쳐야 했는데, 이를 CLI 명령으로 통합하여 설정 파일과 날짜 입력만으로 검수 가능한 결과물을 받아볼 수 있게 됐다.
Closing
설계부터 배포까지는 적재 모듈 10일, 공개 모듈 2일로, 영업일 기준 총 12일에 걸쳐 진행됐다. 당장의 유지보수 업무에 활용하려고 최대한 서둘러 마무리 지은 부분도 있지만, 개발 환경 자체의 제약도 적지 않은 영향을 미쳤다. 기능을 테스트할 때 데이터베이스와 운영 플랫폼 API가 필수인 상황으로 인해 분리망 환경은 큰 장애물이었다. 특히 이런 대용량 데이터 파이프라인의 설계를 처음 해보는 상황에서 적극적으로 실행 테스트를 진행해보기 어려웠다.
구체적인 성능 병목 등을 자세히 파악하기가 힘들었고, 일부는 제한된 정보와 가설에 따라 구현할 수밖에 없었다. 하지만 이번 재설계는 처리 성능 면에서의 무조건적인 향상보다, 여러 제약 조건 하에서 안정적이면서도 사람과 컴퓨터 양방의 자원을 절약하는 데에 중점을 두고 진행했다.
운영 절차 간소화라는 목표를 달성하기 위한 방법과 고려한 사항은 제각기 달랐지만, CLI 기반의 일관된 실행 환경으로 통합함으로써 기존 절차 대비 분명한 이점을 챙길 수 있었다. 수작업 절차마다 알아야 했던 명령어, 운영 서버에 마련된 작업용 디렉토리 경로를 더 이상 신경쓰지 않아도 됐다. 9장이 넘어가던 설명 문서를 표 하나로 정리할 수 있었다. 다른 업무를 병행할 수 있게 된 것도 큰 성과 중 하나이다. 작업 진행 중 여부가 표시되고, 결과를 산출물로 남기게 하면서 작업에 개입할 필요가 사라진 덕분이다.
사람이 업무 절차에 종속되지 않고, 컴퓨터 역시 주어진 자원 안에서 무리 없이 작업을 수행할 수 있는 환경을 만들어냈다는 점에 이번 재설계의 의의를 두고자 한다.
the design which occurs first is almost never the best possible — Melvin Conway, How Do Committees Invent? (1968)
이번 작업은 소프트웨어 아키텍처의 특징 중 을 다시 확인한 사례이기도 하다. 일반적으로 설계는 구현에 앞서 이루어지지만, 실제 구현 과정에서 발견되는 문제와 새로운 요구사항이 다시 설계에 영향을 미친다. 설계와 구현이 서로 영향을 주고받는 것이다.
전체 작업 과정 중에서 일관되게 유지한 것은 설계 자체를 가설로 간주하는 태도와 최종 목표뿐이었다. 구현 중에 상세 설계를 결정했고, 이는 또 뒤집어지기를 반복했다. 얼핏 상반되어보이는 적재와 동기화 작업의 실패 정책은 계획조차 하지 않았었다. 구현을 진행하면서 데이터의 특성과 실패가 미치는 영향을 이해하게 됐고, 이를 바탕으로 실패 시 처리 방법을 적용하게 된 결과이다.
결국 이번 재설계는 단순한 레거시 이관이나 업무 절차 자동화가 아니었다. 업무의 목적과 절차의 구성, 작업의 특성을 다시 살펴보며 각 문제를 어떤 방식으로 해결할 수 있을지 분석하고, 이를 바탕으로 전체 작업 흐름을 재정의하는 과정이었다. 레거시는 그 과정에서 참조할 수 있는 자료였다. 기존에는 문제를 어떻게 정의했고 해결했는지, 지금의 상황과는 어떤 차이가 있는지 등을 대조해가며 재설계의 방향을 잡아주는 이정표로 삼을 수 있었다.